AI는 프로그래밍보다 데이터 디버깅의 비중이 더 높기 때문에 지속적이며 생산적인 데이터 확보가 중요하다.
자율주행 차량용 카메라만 하더라도 사물 하나당 100만장 가량의 영상 학습이 필요하고 실제 스탠퍼드 대학도 ImageNet 경진대회에 사용된 약 1,400만 장의 이미지를 가공하기 위해 6년에 걸쳐 약 1,000여 명을 투입했다고 한다. 올해 우리나라의 최저시급으로 계산하면 약 1,200억원(이미지 1 장 당 8,975원)으로 향후 데이터 수집?가공 시장의 잠재력을 어느 정도 짐작해볼 수 있는 대목이다.
우리나라의 AI 산업 구조를 살펴보면 민간 데이터 판매/대행 시장이 활성화 되어있지 않아 주로 자급자족하거나 정부의 지원을 받아 학습용 데이터를 확보하고 있는데 시간과 예산의 제약이 많은 기업들은 충분한 데이터를 통한 AI 학습으로 원하는 결과값을 얻어내기가 쉽지 않은 상황이다.
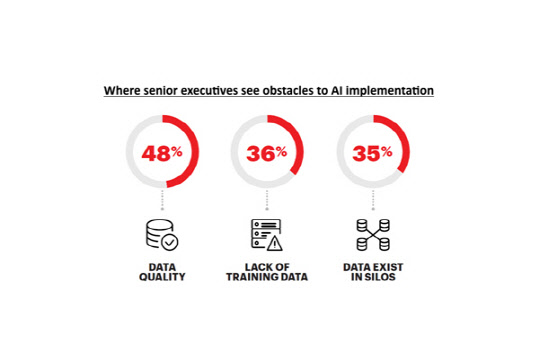
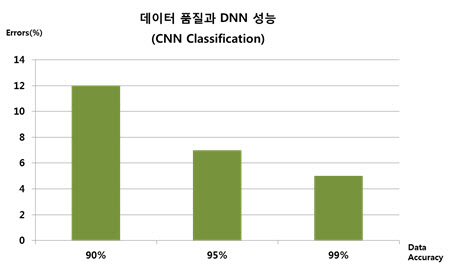
다국적 경영 컨설팅 기업인 액센츄어는 블로그에 AI 구현에 있어 임원들이 생각하는 가장 큰 장애요인으로 데이터의 절대적인 볼륨(양)보다 가공을 통해 생성한 데이터의 품질을 꼽는데 방대한 양의 데이터를 비정형 데이터를 AI별 학습 기준에 맞게 Tagging과 Labeling하는 가공능력에 따라 AI의 학습 결과값에 큰 영향을 미치기 때문이다.
[출처] 액센츄어 인슈어런스
[출처] ICT 산업전망컨퍼런스 2019
실제 산업현장에서도 데이터 산업에 대한 중요성에 대해서 계속 강조하고 있다.
국내 AI용 데이터 전문 업체 인피닉은 "대부분의 국내기업은 비용문제로 AI 학습용 데이터를 직접 수집?가공하려고 하기 때문에 양과 품질의 한계가 발생하므로 당사와 같이 전문가를 보유한 전문업체를 통해 데이터를 확보하는 해외기업과의 격차가 계속 발생할 수 밖에 없다"고 지적했다.
국내에는 전문적으로 제공하는 수집?가공업체가 몇 없고 수작업이 중심이기 때문에 비용이 많이 드는 환경에 대해서도 "국내기업에게 합리적인 가격으로 고품질의 학습용 데이터를 제공하는 민간 데이터 센터와 데이터 가공 자동화 솔루션 시장이 곧 대두될 것"이라고 했다.
바야흐로 산업 발전을 위해 정부 주도의 데이터 구축?보급 뿐만이 아니라 민간 데이터 수집?판매 시장이 활성화되어 AI산업이 동반 성장하는 선순환 생태계가 필요한 시점이다.